RUNTIME PROOF-OF-CONCEPT · AGILES PROJEKT

NAB9 Runtime Monitoring

Aus realer Last entstand ein eigenes kleines agiles Projekt mit Epic, sechs Sprints und 15 User Stories.

Diese Seite dokumentiert den technischen Runtime-Monitoring-Baustein der OPS-Übergabe. Im Rahmen eines prototypischen Decision- und Process-Simulation-Frameworks wurde ein Betriebs- und Monitoringkonzept für einen lokal betriebenen KI-/LLM-Server entworfen und umgesetzt. Ziel war eine stabile, nachvollziehbare und betrieblich kontrollierbare Monitoring-Lösung für einen KI-gestützten Analyse- und Simulationsserver auf Basis eines lokalen High-Performance Mini-PC.

1 Epic 6 Sprints 15 User Stories 4 Sensor-Fallbacks
EXECUTIVE RUNTIME SUMMARY

Warum Runtime Monitoring für einen lokalen LLM-Server relevant ist

Lokale KI-/LLM-Systeme erzeugen unter realer Nutzung spürbare Last auf CPU und GPU. Ohne strukturiertes Monitoring bleibt das Verhalten der Plattform intransparent. Und damit bleibt auch die Frage offen, ob sie betreibbar ist.

🔥

Thermische Stabilität

Frühzeitige Erkennung kritischer CPU-Temperaturen, bevor das System throttled oder ausfällt.

🏠

Lokaler Betrieb

Keine Cloud-Abhängigkeit, keine laufenden Lizenzkosten. Die Demo läuft auf bestehender Hardware.

🔔

Strukturiertes Alerting

Operations-Kanal erhält strukturierte Meldungen nur bei echten Statuswechseln, nicht bei jeder Messung.

📐

Zustandskontrolle

Sensor-Rohwerte werden in vier klare Betriebszustände übersetzt: OK · WARN · CRIT · SENSORERROR.

📝

Log- & Servicefähig

Konfigurierbare Retention, strukturierte Felder, vorbereitet für ITSM-/Ticket-Integration.

🤝

Übergabefähig

Dokumentation, Architektur, Fachbegriffe und Story-Backlog stehen für die OPS-Übergabe bereit.

ARCHITEKTUR

Monitoring & Betriebsmodell für den lokalen LLM-Server

Die folgende Architektur zeigt den End-to-End-Flow von Hardware über Sensorquellen, Zustandsbewertung, Alarmierung und Protokollierung bis zur Service-Integration. Sechs nummerierte Blöcke, Fachbegriffe mit Quellenangaben, Komponenten-Übersicht und Nutzen der Lösung sind direkt im Diagramm erklärt. Klick öffnet die Grossansicht.

Architekturdiagramm: Monitoring & Betriebsmodell für lokalen LLM-Server mit Infrastruktur, Monitoring, Auswertung, Alarmierung, Protokollierung und Automatisierung
End-to-End-Architektur: MiniPC NAB9 · LLM Runtime · Sensor-Stack · Zustandslogik · Telegram Operations · Service-Integration · Governance
AGILE UMSETZUNG

Epic · 6 Sprints · 15 User Stories

Auch ein kleines Betriebsprojekt verdient saubere Struktur. Der PoC wurde als eigenständiges agiles Projekt aufgesetzt, mit Epic, klar zugeschnittenen Sprints, User Stories nach „Als <Rolle> möchte ich <Ziel>, damit <Nutzen>", Acceptance Criteria und technischen Tasks.

Epic

Local LLM Runtime Monitoring Platform

Aufbau einer lokal betriebenen Runtime- und Monitoringplattform zur technischen Überwachung eines KI-/LLM-Servers inklusive Alarmierung, Betriebsintegration und Serviceübergabe. Ohne Cloud-Abhängigkeit, ressourcenschonend, mit nachvollziehbarem Statusmodell und vorbereiteter Service- und Supportintegration.

6Sprints
15User Stories
OK·WARN·CRIT·SENSORERRORStatusmodell
4-stufigSensor-Fallback

Sprint-Übersicht

Sprint 1

Infrastruktur & Runtime Basis

Lokale Runtime- und Monitoring-Grundlage aufbauen, Pfade und Ausführungsumgebung definieren.

US1US2
Sprint 2

Sensor- & Temperaturüberwachung

CPU-Temperatur und Sensorwerte erfassen, Fallback-Kaskade implementieren.

US3US4
Sprint 3

Eskalations- & Alarmierungslogik

Messwerte in betriebliche Zustände übersetzen, Hysterese und Overshoot.

US5US6US7US8
Sprint 4

Telegram Runtime Alerting

Operations bei Statuswechseln automatisch informieren, strukturierte Nachrichten.

US9US10
Sprint 5

Logging & Runtime Stabilität

Ereignisse nachvollziehbar protokollieren, Logs wartbar halten, Sensorfehler isolieren.

US11US12US13
Sprint 6

Betriebsintegration & Service Management

Übergabe an Operations und Service-/Ticketintegration vorbereiten.

US14US15

User Stories · Acceptance Criteria · Tasks

Als Betreiber möchte ich den lokalen KI-/LLM-Server auf bestehender Hardware betreiben, damit die Demo ohne Cloud-Abhängigkeit und ohne laufende Betriebskosten genutzt werden kann.
Acceptance Criteria
  • Lokale Runtime-Umgebung ist beschrieben
  • Hardwarebasis ist dokumentiert
  • Keine Cloud-Abhängigkeit ist notwendig
  • Betriebsziel ist nachvollziehbar
  • Grundstruktur für Monitoring ist vorhanden
Technische Tasks
  • Runtime-Verzeichnis definieren
  • Monitoring-Pfade konfigurieren
  • PowerShell-Ausführungsumgebung prüfen
  • README / OPS-Hinweise ergänzen
  • Lokale Ausführungsrechte prüfen
Als Operations-Verantwortlicher möchte ich eine klare Verzeichnis- und Dateistruktur, damit Skript, Logs, Statefile und Sensorbibliotheken nachvollziehbar abgelegt sind.
Acceptance Criteria
  • Pfadstruktur ist dokumentiert
  • Logfile-Pfad ist definiert
  • Statefile-Pfad ist definiert
  • DLL-Pfade sind nachvollziehbar
  • Verzeichnis kann wiederhergestellt oder migriert werden
Technische Tasks
  • Verzeichnisstruktur definieren
  • Logfile-Pfad setzen
  • Statefile-Pfad setzen
  • DLL-Kandidaten für LibreHardwareMonitor / OpenHardwareMonitor dokumentieren
  • Pfadprüfung im Skript implementieren
Als Operations Team möchte ich CPU-Temperaturdaten erfassen, damit thermische Risiken frühzeitig erkannt werden.
Acceptance Criteria
  • CPU-Temperatur wird zyklisch erfasst
  • Sensorquelle wird ausgewiesen
  • CPU Package, Core Max oder Core Average werden bevorzugt
  • Ungültige oder leere Sensorwerte lösen keinen falschen Alarm aus
  • Fallbacks werden genutzt, wenn primäre Sensorquelle nicht verfügbar ist
Technische Tasks
  • LibreHardwareMonitor anbinden
  • CoreMax / Package priorisieren
  • Null-Werte und NaN-Werte filtern
  • Temperaturwerte plausibilisieren
  • Sensorquelle in Ergebnis aufnehmen
Als technischer Betreiber möchte ich verschiedene Sensorquellen nutzen, damit das Monitoring auch bei Ausfall einer Quelle weiter Informationen liefern kann.
Acceptance Criteria
  • Primäre Sensorquelle ist LibreHardwareMonitor
  • OpenHardwareMonitor ist als Fallback vorbereitet
  • WMI ThermalZone ist als Last-Resort-Fallback verfügbar
  • EXE Report Fallback ist vorbereitet
  • Fehler je Sensorquelle werden protokolliert
Technische Tasks
  • LibreHardwareMonitor DLL laden
  • Assembly Resolver implementieren
  • OpenHardwareMonitor Fallback vorbereiten
  • WMI/CIM-Abfrage implementieren
  • EXE Report Fallback implementieren
  • Fehlerbehandlung je Quelle ergänzen
Als Operations Team möchte ich Temperaturzustände in OK, WARN, CRIT und SENSORERROR überführen, damit technische Messwerte in betriebliche Zustände übersetzt werden.
Acceptance Criteria
  • Status OK wird bei unkritischen Werten gesetzt
  • Status WARN wird ab definiertem Warnschwellenwert gesetzt
  • Status CRIT wird ab definiertem Kritischschwellenwert gesetzt
  • SENSORERROR wird gesetzt, wenn keine verwertbaren Sensorwerte verfügbar sind
  • Status wird im Statefile gespeichert
Technische Tasks
  • Get-BaseState implementieren
  • WARN- und CRIT-Schwellwerte konfigurierbar machen
  • SENSORERROR Handling implementieren
  • Statefile lesen und schreiben
  • Statuswechsel auswerten
Als Betreiber möchte ich Warn- und Kritischwerte konfigurieren, damit das Monitoring an Hardware und Betriebssituation angepasst werden kann.
Acceptance Criteria
  • Warnschwelle ist konfigurierbar
  • Kritischschwelle ist konfigurierbar
  • Werte können ohne Code-Umbau angepasst werden
  • Änderung beeinflusst Alerting und Statusbewertung
  • Konfiguration ist verständlich dokumentiert
Technische Tasks
  • $WarnThreshold definieren
  • $CritThreshold definieren
  • Kommentare im Skript ergänzen
  • Beispielwerte dokumentieren
  • Schwellenlogik testen
Als Operations Team möchte ich Hysterese verwenden, damit das System bei schwankenden Temperaturwerten nicht ständig zwischen Zuständen wechselt.
Acceptance Criteria
  • Downgrade von CRIT erfolgt erst unterhalb CRIT minus Hysterese
  • Downgrade von WARN erfolgt erst unterhalb WARN minus Hysterese
  • Upgrades erfolgen sofort
  • Flattereffekte werden reduziert
  • Hysterese-Wert ist konfigurierbar
Technische Tasks
  • Apply-Hysteresis implementieren
  • $HysteresisDeg konfigurieren
  • Statuswechsel testen
  • Downgrade-Regeln dokumentieren
  • Logeinträge für stabile Zustände erzeugen
Als Operations Team möchte ich Überschreitungen oberhalb der Grenzwerte erkennen, damit stärkere Warnungen sichtbar werden, ohne das gesamte Statusmodell zu verkomplizieren.
Acceptance Criteria
  • WARN_OS wird bei WARN plus Overshoot gesetzt
  • CRIT_OS wird bei CRIT plus Overshoot gesetzt
  • Overshoot verändert nicht zwingend den Base-State
  • Label wird in Telegram-Meldung und Logeintrag angezeigt
  • Overshoot-Wert ist konfigurierbar
Technische Tasks
  • Get-Label implementieren
  • $OvershootDeg definieren
  • WARN_OS und CRIT_OS ausgeben
  • Telegram-Meldung erweitern
  • Test mit Beispieltemperaturen durchführen
Als Operations Team möchte ich bei relevanten Zustandsänderungen automatisch informiert werden, damit kritische Runtime-Zustände nicht manuell geprüft werden müssen.
Acceptance Criteria
  • Telegram-Meldung wird bei Statuswechsel gesendet
  • Meldung enthält Zustand, Temperatur, Load, Zeitpunkt und Quelle
  • Telegram-Konfiguration erfolgt über Umgebungsvariablen
  • Fehlende Telegram-Konfiguration wird protokolliert
  • Bot-Token und Chat-ID werden nicht hardcoded
Technische Tasks
  • Telegram API SendMessage implementieren
  • TELEGRAM_BOT_TOKEN aus Umgebungsvariable lesen
  • TELEGRAM_CHAT_ID aus Umgebungsvariable lesen
  • Send-Telegram Funktion implementieren
  • Fehlerbehandlung ergänzen
  • Telegram-Test durchführen
Als Operations Team möchte ich strukturierte Alerts erhalten, damit ich Zustand, Temperatur, Load und Sensorquelle schnell erkennen kann.
Acceptance Criteria
  • Meldung enthält Host/Servername NAB9
  • Meldung enthält Statuslabel
  • Meldung enthält CPU-Temperatur und Load
  • Meldung enthält Zeit und Datum
  • Meldung enthält Sensorquelle
  • Meldung ist kurz und mobil gut lesbar
Technische Tasks
  • Nachrichtenformat definieren
  • Statussymbole / Emojis verwenden
  • Temperatur und Load formatieren
  • Zeitpunkt formatieren
  • Sensorquelle anhängen
  • Beispiele dokumentieren
Als Betreiber möchte ich Monitoring-Ereignisse protokollieren, damit Betriebszustände, Fehler und Eskalationen nachvollziehbar bleiben.
Acceptance Criteria
  • Jeder Skriptlauf wird protokolliert
  • Sensorfehler werden protokolliert
  • Statuswechsel werden protokolliert
  • Telegram-Versand wird protokolliert
  • Keine-Meldung-Fälle werden protokolliert
  • Logeinträge enthalten Zeitstempel
Technische Tasks
  • Write-Log Funktion implementieren
  • Ensure-Path Funktion implementieren
  • Logfile anlegen, falls nicht vorhanden
  • Fehlerquellen protokollieren
  • Status- und Alert-Informationen loggen
Als Betreiber möchte ich alte Logeinträge automatisch entfernen, damit das Logfile langfristig wartbar bleibt.
Acceptance Criteria
  • Retention-Zeitraum ist konfigurierbar
  • Einträge älter als definierte Tage werden entfernt
  • Logfile bleibt lesbar
  • Optional: maximale Größe begrenzen
  • Rotation läuft automatisch während Skriptausführung
Technische Tasks
  • $LogRetentionDays definieren
  • Zeitstempel aus Logzeilen parsen
  • Cutoff-Datum berechnen
  • Alte Logzeilen herausfiltern
  • Datei neu schreiben
  • Optional Max-Size-Regel implementieren
Als Operations Team möchte ich Sensorfehler eindeutig erkennen, damit Monitoring-Probleme nicht unbemerkt bleiben.
Acceptance Criteria
  • Sensorfehler führt zu SENSORERROR
  • SENSORERROR wird im Statefile gespeichert
  • SENSORERROR wird per Telegram gesendet
  • Wiederholte identische Sensorfehler erzeugen keine Alert-Flut
  • Fehlerursache wird im Log dokumentiert
Technische Tasks
  • Fehlerbehandlung für LHM implementieren
  • Fehlerbehandlung für OHM implementieren
  • Fehlerbehandlung für WMI implementieren
  • Fehlerbehandlung für EXE Fallback implementieren
  • SENSORERROR Logik testen
Als Support-Team möchte ich Monitoring-Ereignisse später in ein Ticket-/Serviceumfeld überführen können, damit Betriebsereignisse nachvollziehbar bearbeitet werden können.
Acceptance Criteria
  • Service-/Ticketkontext ist dokumentiert
  • Relevante Alertdaten sind strukturiert
  • Ticketfähigkeit ist konzeptionell vorbereitet
  • Link zum Ticket-/Service-System kann eingebunden werden
  • Betriebsereignisse sind über Logs nachvollziehbar
Technische Tasks
  • Ticket-Link auf Website integrieren
  • Alert-Datenfelder definieren
  • Übergabeinformationen dokumentieren
  • Serviceprozess beschreiben
  • Jira-/Atlassian-Kontext auf OPS-Seite einordnen
Als Operations Team möchte ich eine verständliche Betriebsdokumentation erhalten, damit die Lösung nachvollziehbar übernommen, überwacht und erweitert werden kann.
Acceptance Criteria
  • Zweck der Lösung ist beschrieben
  • Architektur ist visualisiert
  • Alerting-Logik ist erklärt
  • Schwellenwerte sind erklärt
  • Sensorquellen und Fallbacks sind erklärt
  • Logs und Statefile sind erklärt
  • Service-/Ticketintegration ist beschrieben
  • Erweiterungsmöglichkeiten sind erkennbar
Technische Tasks
  • OPS-Hauptseite erstellen
  • NAB9-Detailseite erstellen
  • Architekturdiagramm einbinden
  • Telegram-Screenshots einbinden
  • Fachbegriffe erklären
  • Detailbereich strukturieren
  • Doppelklick-Zoom für Bilder einbauen
MONITORING IN AKTION

Telegram Operations Channel: strukturierte Runtime-Meldungen

Der dedizierte Operations-Channel erhält strukturierte Alerts mit Host, Statuslabel, CPU-Temperatur, Load, Zeitstempel und Sensorquelle. Meldungen werden nur bei echten Statuswechseln gesendet, nicht bei jeder Messung.

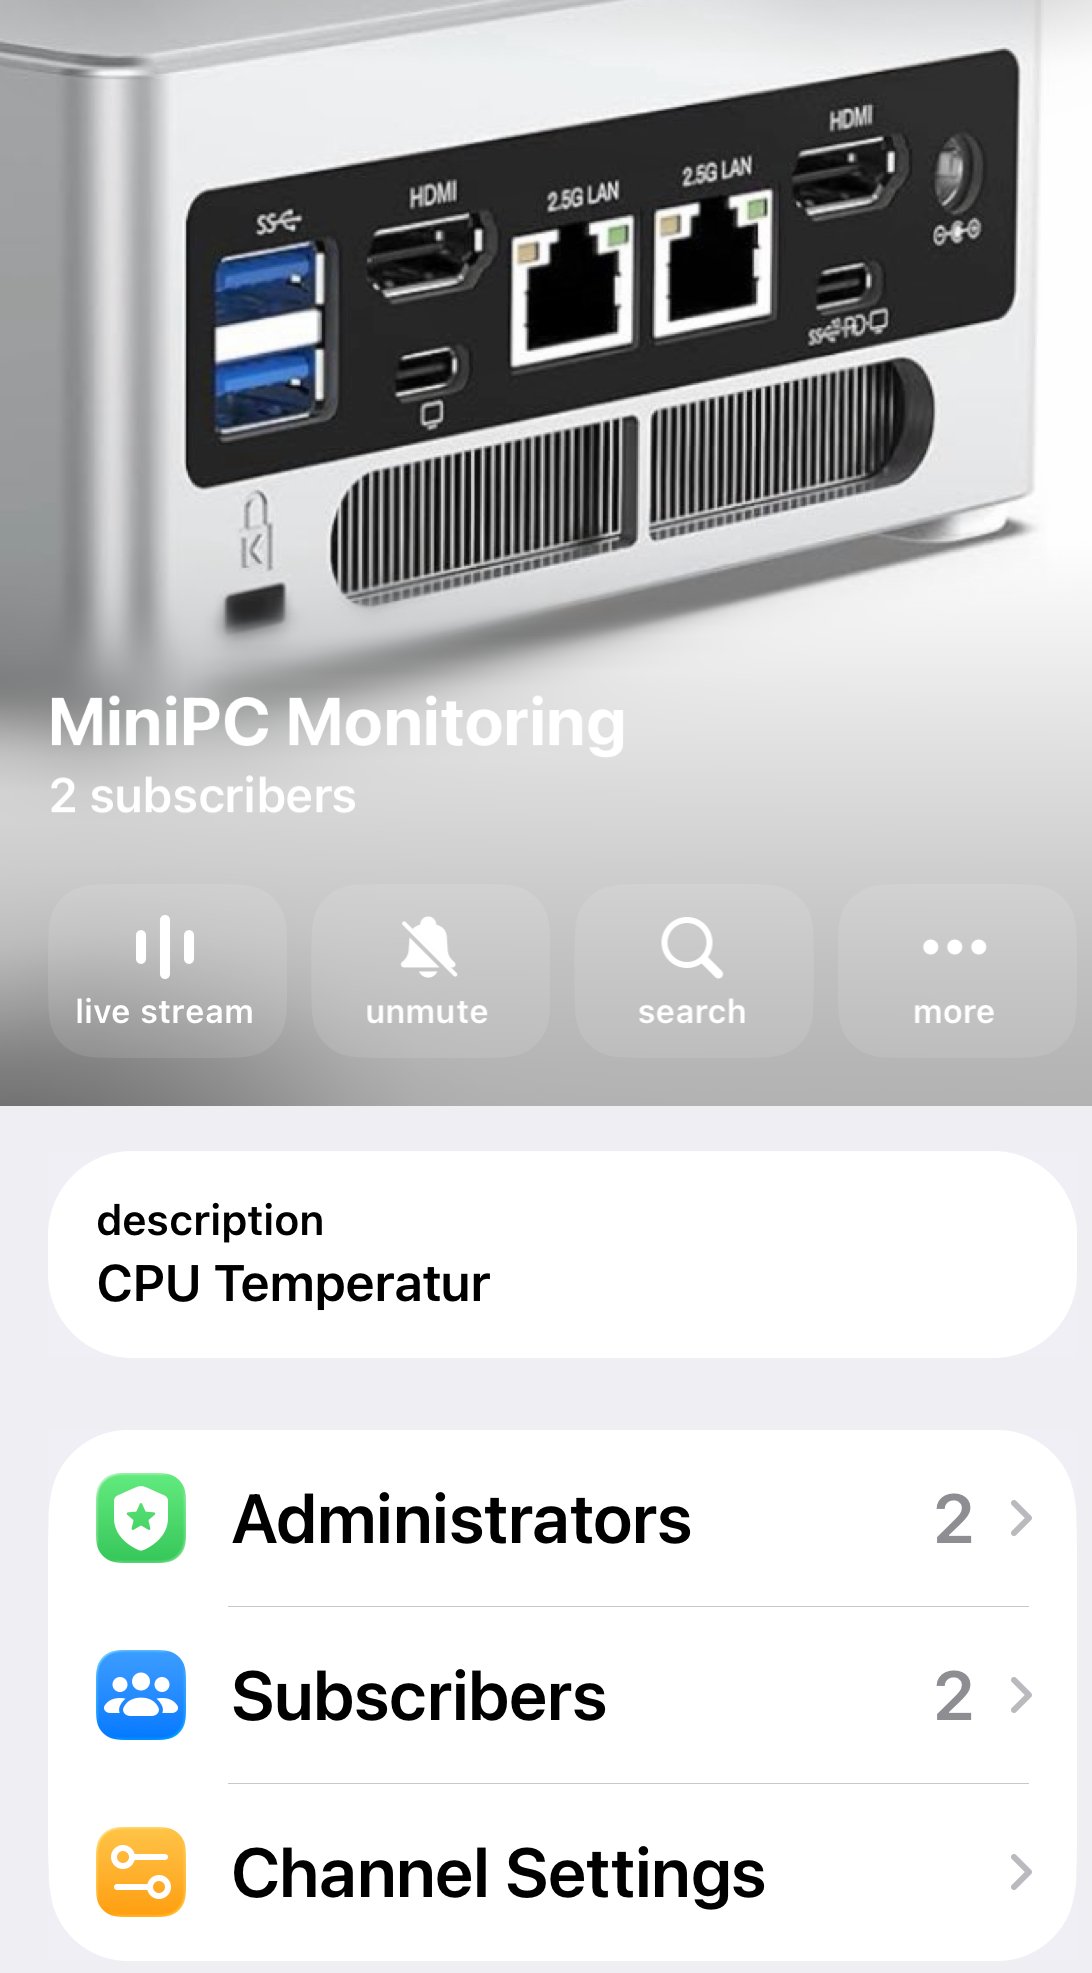
Telegram-Channel 'MiniPC Monitoring' mit NAB9-Hardware im Profil-Header
Dedizierter Operations-Channel

„MiniPC Monitoring": geschlossener Runtime-Kreislauf

Ein eigener Telegram-Channel agiert als zentraler Operations-Touchpoint mit definiertem Abonnentenkreis (Administratoren + Subscribers). Das Header-Bild zeigt die echte NAB9-Hardware. Hardware, Monitoring-Skript und Channel bilden zusammen einen geschlossenen Runtime-Kreislauf, der ohne Cloud-Dienste auskommt.

Telegram-Channel MiniPC Monitoring mit Beispielmeldungen WARN_OS und CRIT_OS
Live empfangene Runtime-Alerts im Operations-Channel (Klick für Grossansicht)
⚠️ NAB9 WARN_OS
🌡️ CPU: 79°C
📊 Load: 68%
🕒 22:36 | 14.05.2026
📡 Quelle: LHM:CoreMax
🔴 NAB9 CRIT_OS
🔥 CPU: 93°C
📊 Load: 70%
🕒 23:06 | 14.05.2026
📡 Quelle: LHM:CoreMax
⚪ NAB9 SENSORFEHLER
Keine Temperaturwerte verfügbar. Die Sensor-Fallback-Kaskade meldet Ausfall aller Quellen.
SKALIERUNG & ROADMAP

Vom NAB9 in die GPU-Cloud und weiter zur Online-API

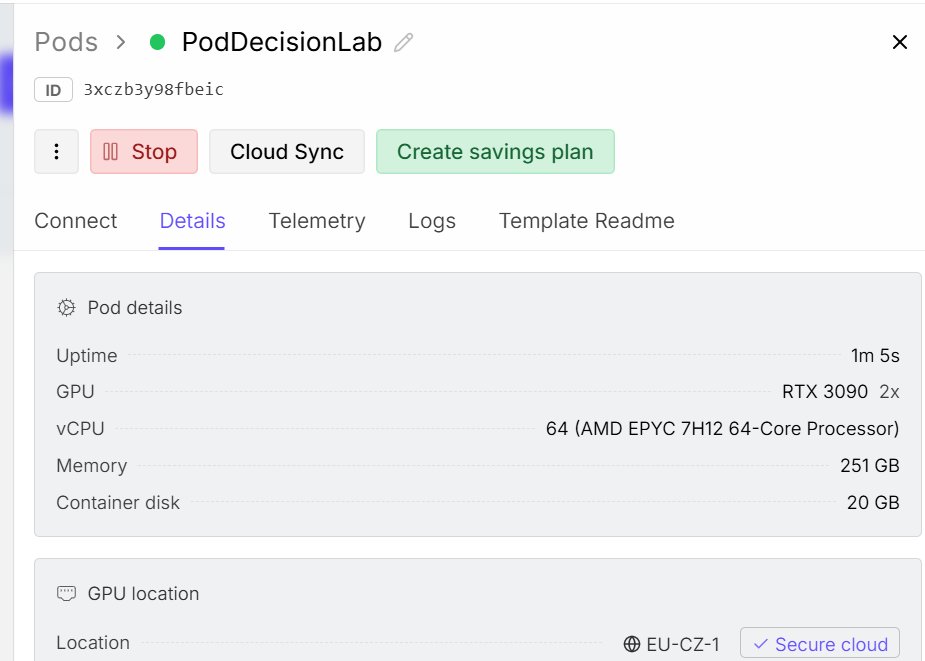
Der NAB9 ist die richtige Hardware für eine lokale Demo bis zu einer überschaubaren Last. Die integrierte GPU stösst aber bei stärkerer Simulation an klare Grenzen. Sobald das Framework mehr als fünf Agents gleichzeitig simulieren soll, wird die Antwortzeit zu lang. Bei der „Hardcore Full Simulation Group" mit 16 Agents wäre der NAB9 schlicht überfordert. Diese Grenze ist nicht ein Fehler, sondern ein Architektur-Trigger.

⚡ Architektur-Trigger: > 5 Agents bedeutet zu lange Wartezeit auf dem NAB9. 16 Agents („Hardcore Full Simulation Group") sind lokal nicht praktikabel. Die Lösung wird stufenweise in die GPU-Cloud verlagert und am Ende auf Online-Modelle umgestellt.
Phase 1 · Heute ✓ Implementiert

Lokal auf dem NAB9

Mini-PC mit integrierter GPU
Hardware
Intel i9-12900HK
GPU
Integriert (limitiert)
RAM
64 GB
Kapazität
bis 5 Agents
Kosten
0 CHF / Monat

Der aktuelle Stand. Das Setup ist ressourcenschonend, ohne Cloud-Abhängigkeit und ideal für Demo-Zwecke. Innerhalb des Agent-Limits läuft die Simulation flüssig.

Phase 3 · Endstation 🎯 Vision

Direkter Zugriff auf ChatGPT-Online-Modelle

Managed API, ohne eigene Infrastruktur
Backend
OpenAI API (kostenpflichtig)
Modelle
Aktuell verfügbare GPT-Versionen
Skalierung
Unbegrenzt
Kosten
Pay-per-Token
Latenz
Niedrig durch dedizierte Infrastruktur

Die Endvision: keine eigene GPU-Infrastruktur mehr. Das Framework greift direkt auf produktive Online-Modelle zu und nutzt deren professionelle Skalierung und Verfügbarkeit. Lokale Hardware dient dann nur noch als Entwicklungs- und Demo-Umgebung.

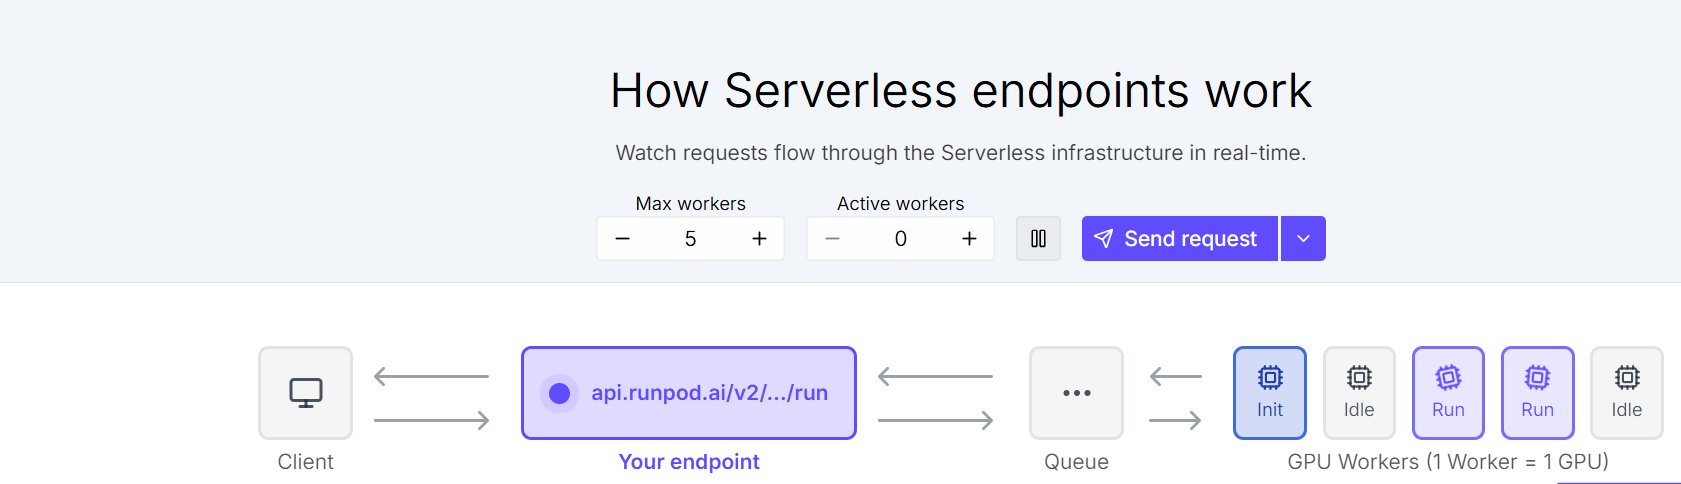
Serverless Endpoint Flow: Client sendet Request an api.runpod.ai/v2/.../run, der in der Queue auf GPU-Worker verteilt wird
Phase 2 im Detail: Wie der Serverless Endpoint funktioniert. Requests landen in einer Queue und werden auf so viele GPU-Worker verteilt, wie aktuell aktiv sind. Bei Inaktivität fahren Worker herunter, damit nur tatsächlich gebrauchte GPU-Zeit kostet.
TECHNISCHE VERTIEFUNG

Komponenten, Skriptaufbau und Fallback-Kaskade

Wer es genauer wissen möchte: hier die technischen Bausteine im Detail. Aufklappbar und je nach Interesse selektiv konsumierbar.

Das Monitoring ist als PowerShell-7-Skript umgesetzt. Es erfasst Sensorwerte, bewertet den Status, wendet Hysterese und Overshoot an, schreibt Logs und Statefile und sendet Telegram-Alerts bei Statuswechsel. Es kann manuell ausgeführt oder über die Windows-Aufgabenplanung periodisch geplant werden.

Warum PowerShell 7? Native Windows-Integration, Task-Scheduler-Anbindung, direkter Zugriff auf DLLs, REST-/Telegram-Aufrufe ohne Drittsoftware, geringer Runtime-Overhead und lokal betreibbar ohne zusätzliche Plattform.

Monitoring-Zyklus (14 Schritte pro Lauf)
  1. 1 Scriptstart
  2. 2 Sensor-Initialisierung
  3. 3 CPU-Temperaturwerte erfassen
  4. 4 CPU-Auslastung erfassen
  5. 5 Temperatur plausibilisieren
  6. 6 Base-State bestimmen (Get-BaseState)
  7. 7 Hysterese anwenden (Apply-Hysteresis)
  8. 8 Overshoot-Label bestimmen (Get-Label)
  9. 9 Vorherigen Zustand aus Statefile laden
  10. 10 Statuswechsel erkennen
  11. 11 Telegram-Alert auslösen (nur bei Wechsel)
  12. 12 Logeintrag schreiben
  13. 13 Statefile aktualisieren
  14. 14 Scriptende

Eine einzige Sensorquelle wäre Single Point of Failure. Die Kaskade greift in dieser Reihenfolge:

  • Primär – LibreHardwareMonitor (über LibreHardwareMonitorLib.dll): CPU Package, Core Max, Core Average
  • Fallback 1 – OpenHardwareMonitor (über OpenHardwareMonitorLib.dll)
  • Fallback 2 – WMI/CIM ThermalZone (MSAcpi_ThermalZoneTemperature) als Last-Resort
  • Fallback 3 – LibreHardwareMonitor.exe Report (erfordert ggf. erhöhte Rechte)

Bekannte Stolperfalle in der Umsetzung: Unter PowerShell 7 trat mit bestimmten DLL-Builds der Fehler Method not found: System.Security.AccessControl.FileSecurity auf. Das ist ein Hinweis auf eine .NET-Framework-DLL in einer .NET-Core-Runtime. Lösung: kompatible LibreHardwareMonitor-DLL verwenden oder PowerShell 5.1 für Sensorzugriffe nutzen.

WMI-Praxis: warum nur als Last-Resort

WMI liefert Temperaturwerte in einem ungewöhnlichen Format: Kelvin multipliziert mit 10. Die Umrechnung erfolgt deshalb mit ($value / 10) - 273.15. In der realen Umsetzung lieferte WMI für den NAB9 trotz spürbarer CPU-Last nur 27.9 °C. Der Grund: WMI greift oft nur auf ACPI-/System-Thermal-Zones zu, nicht auf die echten CPU-Core-Sensoren. Je nach BIOS und Hersteller liefert WMI deshalb unplausibel niedrige Werte. Deshalb wird WMI bewusst nur als Last-Resort verwendet, wenn LibreHardwareMonitor und OpenHardwareMonitor beide ausfallen.

Temperatur und Load werden in vier Betriebszustände übersetzt: OK, WARN, CRIT, SENSORERROR. Schwellwerte sind konfigurierbar (z. B. WARN ab 70 °C, CRIT ab 80 °C).

Hysterese: Ein Downgrade erfolgt erst, wenn die Temperatur klar unter Schwelle − Hysterese fällt. Damit wird Flattern um die Schwelle herum verhindert.

Overshoot: Liegt der Wert deutlich über der Schwelle, erzeugt das Skript ein zusätzliches Label (WARN_OS, CRIT_OS). Der Base-State bleibt gleich, der Betrieb erkennt aber, dass die Lage relevanter ist.

Das Statefile speichert den letzten bekannten Zustand. So sendet das System nicht bei jedem Lauf dieselbe Meldung, sondern nur bei echten Statuswechseln, beim Erstauftreten eines Sensorfehlers oder bei explizit aktiviertem AlwaysNotify.

  • prev = OK, neu WARN → Meldung wird gesendet
  • prev = WARN, neu wieder WARN → keine Meldung
  • prev = CRIT, Temperatur sinkt aber bleibt über CRIT−Hysterese → keine verfrühte Entwarnung
  • Sensorfehler nach OK → eigenständiger SENSORERROR-Alert

Bot-Token und Chat-ID liegen ausschliesslich in Umgebungsvariablen (TELEGRAM_BOT_TOKEN, TELEGRAM_CHAT_ID). Sie befinden sich niemals im Skript.

Das Logfile enthält Skriptstart, Sensorinformationen, Fehler, Statusbewertung, Telegram-Versand und „Keine-Meldung"-Fälle, jeweils mit Zeitstempel. Eine konfigurierbare Retention (z. B. 2 Tage) entfernt alte Einträge automatisch. Zusätzlich kann eine maximale Logfile-Grösse definiert werden.

So bleibt das Logfile langfristig lesbar und ohne Log-Wildwuchs. Die Lösung bleibt damit nachvollziehbar wartbar.

Das Skript wird über die Windows-Aufgabenplanung periodisch ausgeführt, typischerweise im Minuten- oder Stundenintervall. Damit entsteht eine kontinuierliche Runtime-Überwachung ohne dauerhaft laufenden Dienst.

  • Hintergrundausführung mit minimaler Last
  • Autostart nach Reboot
  • Konfigurierbares Intervall
  • Logging deckt jeden Lauf ab

Die strukturierten Alert-Felder (Host, Status, Temperatur, Load, Quelle, Zeitstempel) sind so vorbereitet, dass sie in ein ITSM-/Ticket-System überführt werden können. Sie sind konzeptionell anschlussfähig an Jira-/Servicedesk-Prozesse. Betriebsereignisse bleiben über Logs nachvollziehbar.

Alle Komponenten der Lösung liegen in einer klar definierten Verzeichnisstruktur. Das macht Wiederherstellung, Migration oder Übergabe an Operations trivial.

C:\DATEN\PowerShell_Scripte\TempMonitor\
  ├─ TempMonitor.ps1              # Hauptskript
  ├─ TempMonitor.log             # Runtime- und Betriebslog
  ├─ TempMonitor.state          # Letzter bekannter Zustand
  ├─ LibreHardwareMonitorLib.dll  # Primäre Sensorbibliothek
  ├─ OpenHardwareMonitorLib.dll   # Fallback-Sensorbibliothek
  ├─ LibreHardwareMonitor.exe     # Optionaler EXE-Fallback
  ├─ LibreHardwareMonitor\
  ├─ OpenHardwareMonitor\
  ├─ Logs\
  └─ Archive\

Die aktuelle Lösung deckt CPU-Temperatur, Load, Statusmodell und Alerting ab. Die Architektur ist bewusst modular gehalten, damit weitere Monitoring-Dimensionen ohne Neuaufbau ergänzt werden können. Mögliche Erweiterungen:

  • →GPU-Monitoring
  • →RAM-Monitoring
  • →SSD-Health-Überwachung
  • →Windows-Event-Log-Integration
  • →Web-Dashboard mit Live-Werten
  • →Grafana-/Prometheus-Anbindung
  • →REST-API für externe Tools
  • →Ticket-Auto-Creation (Jira)
  • →Multi-Host-Monitoring
  • →Agent-Monitoring (Framework)
  • →Docker-Runtime-Integration
  • →VMware-Runtime-Integration
  • →E-Mail- / Teams- / Slack-Alerts
  • →Historische Trendanalyse
FACHBEGRIFFE

Glossar für die OPS-Übergabe

Damit Betrieb, Fachbereich und Management dieselbe Sprache sprechen: die wichtigsten Begriffe kurz erklärt.

Monitoring
Kontinuierliche Beobachtung von Runtime-Zuständen mit dem Ziel, kritische Lagen frühzeitig zu erkennen.
Hysterese
Verhindert Flattern: Downgrade erfolgt erst, wenn der Wert klar unter Schwelle minus Hysterese fällt.
Overshoot
Deutliche Überschreitung der Schwelle → Label WARN_OS / CRIT_OS zur Verschärfung.
Fallback
Ersatzquelle, die übernimmt, wenn die primäre Sensorquelle nicht verfügbar ist.
Statefile
Persistenter Speicher des letzten bekannten Zustands. Verhindert doppelte Alerts bei stabilem Status.
SENSORERROR
Eigener Statuswert für „Monitoring funktioniert nicht", klar abgegrenzt von Temperatur-Alarmen.
Runtime
Die laufende Ausführungsumgebung des KI-/LLM-Servers samt aller aktiven Prozesse.
ITSM
IT Service Management. Disziplin und Toolset für strukturierten Betrieb (Incident, Change, Problem).

Der NAB9-Monitor zeigt, wie ein Senior Business Analyst Runtime-Themen nicht nur dokumentiert, sondern als kleines agiles Projekt führt: vom Epic über Sprints und User Stories bis zur betreibbaren Übergabe.